
Qwen3.8-27B на clore.ai (Uncensored) — текстовая модель на 27 млрд параметров. Она отвечает на вопросы, пишет черновики и помогает с кодом на арендованной видеокарте. Фильтр отказа у публичной Qwen3.8-27B здесь снят сборкой Heretic. Запрос остаётся на машине заказа и не уходит в публичный чат.
Ниже два способа запуска одной и той же сборки. Q6_K рассчитан на карту 32 ГБ. Q8_0 — самый точный файл этого репозитория, его ставят на RTX PRO 6000 Blackwell 96 ГБ. Линейка Qwen3.8 есть и в размерах, которые в одну карту не входят. Цифры 735 и 882 в названии репозитория — собственные замеры автора на тестах ARC, не независимый рейтинг. Лицензия карточки — Apache 2.0.
Отсутствие фильтра отказа не отменяет закон. Не просите текст, который вредит людям, помогает мошенничеству или касается несовершеннолетних.
Для чего эта модель
Обычному пользователю она нужна как свой чат: сформулировать письмо, разобрать ошибку в команде, набросать план или короткий рассказ. Публичный сервис часть таких запросов обрывает отказом. Эта сборка отказ снимает, а сам текст считается на видеокарте, которую вы арендовали на clore.ai.
База — официальная Qwen3.8-27B. Поверх неё несколько дообучений и слияние, затем повторный проход Heretic. В файле есть режим рассуждения: перед ответом модель пишет блок размышления. На карточке автора для обычных задач рекомендуются температура 1.0, top_p 0.95, top_k 20 и штраф повторов 1.0. Эти параметры одинаковы для обоих способов.
Чем Q6_K отличается от Q8_0
Оба способа ставят одну сборку. Общими остаются образ, порты и сборка llama.cpp. Отличаются файл, видеокарта и длина контекста.
Q6_K занимает 23 582 382 688 байт, около 22 ГБ. Его запускают на одной карте 32 ГБ, например RTX 5090, с контекстом 16 384 токена. На проверенной RTX 5090 этот контекст занял около 24 ГБ из 32 ГБ.
Q8_0 занимает 29 787 699 808 байт. Это самый точный файл в репозитории: веса BF16 автор не выложил. Его запускают на одной RTX PRO 6000 Blackwell 96 ГБ с родным контекстом модели, 262 144 токена. Карта на 48 ГБ держит Q8_0 с коротким контекстом, без запаса на 262 144 токена. Как устроены локальные модели и чем квант отличается от полного веса, разобрано в статье «Локальные ИИ-модели: на чём запускать».
В чате это ощущается так.
- Длина разговора. На Q6_K длинная переписка или большая вставка вытесняют начало диалога. На Q8_0 в тот же разговор помещаются длинная инструкция, большой фрагмент кода и длинная нить сообщений. Это самая заметная разница.
- Короткий ответ. Письмо, план и рассказ из нескольких предложений на обоих файлах выходят похожими. Q8_0 ближе к исходным весам, поэтому реже сбивает точное имя, число и плотный код. Сам автор на замере ARC оценил 4-битный файл примерно в 99% от 8-битного. Q6_K лежит между ними, так что на коротком запросе шаг качества небольшой.
- Ожидание. Более быстрая карта с теми же 32 ГБ сокращает паузу у Q6_K. Текст при том же файле остаётся тем же: качество задаёт квант. Q8_0 на каждый токен читает больше памяти. Карта на 96 ГБ эту паузу сокращает. Число ядер само по себе ответ не улучшает.
- Счёт и скачивание. Q6_K качается быстрее и идёт на более доступной почасовой карте. Q8_0 дольше скачивается и требует карту на 96 ГБ.
Если карта 24 ГБ, Q6_K в неё не входит. Тогда из того же репозитория берут Q4_K_M. Файлы с MTP в имени для первого запуска не нужны: они быстрее только пока модель принимает второй предсказанный токен хотя бы в половине шагов.
Заказ на clore.ai
Дальше общий заказ и общая сборка. На витрине clore.ai включите цену в USD за час. Для Q6_K найдите одну карту на 32 ГБ, для Q8_0 — одну RTX PRO 6000 Blackwell на 96 ГБ. Перед оплатой откройте Balance. Если на счёте ноль, кнопка Rent заказ не создаст.
В диалоге аренды:
- Тип заказа — On-Demand. Spot дешевле, но машину могут забрать в середине скачивания: у Q6_K файл около 22 ГБ, у Q8_0 около 28 ГБ.
- Образ на проверенном заказе — Ubuntu 20.04.6 с PyTorch 2.0.1+cu117, а не
pytorch/pytorch:2.7.1-cuda12.8-cudnn9-devel. В этом образе нет gcc и нет nvcc, glibc 2.31. Готовые бинарники llama.cpp для Ubuntu собраны под glibc 2.38 и не запускаются. Компилятор CUDA 12.8 ставят пакетами из раздела сборки. Во вкладке LLM есть готовый образ Ollama, ollama/ollama. Для этого файла его не берут: карточка рассчитана на Llama 3 и Mistral, а у этого GGUF архитектура qwen35. Готовый Ollama такой файл часто не открывает. Надпись 8 ГБ на карточке — минимум самого образа, не размер файла. Образ ComfyUI тоже не подходит: он поднимает другой интерфейс. - Порты — 22/tcp и 8080/http. Первый для SSH, второй для чата llama.cpp. Веб-порт должен быть именно http, не tcp.
- Оплата с баланса и подтверждение. Адрес SSH и ссылка на порт 8080 появляются в My Orders. Пока файл модели не скачан, страница порта 8080 пустая: сервер чата запускают после сборки.
Если контейнер не стартует и в логе версия CUDA новее драйвера хоста, возьмите образ CUDA не новее версии из карточки сервера. Команды ниже ставят компилятор сами: в проверенном образе его нет.
Сборка llama.cpp
Зайдите по SSH из My Orders. Сначала проверьте, что карта видна. На проверенном образе нет nvcc: пакеты cuda-nvcc-12-8, cuda-cudart-dev-12-8, cuda-cccl-12-8, libcublas-dev-12-8 и libcurand-dev-12-8 ставят компилятор CUDA 12.8. Каталог /usr/local/cuda-12.8/bin добавляют в PATH, иначе команда nvcc не находится. Флаг -DGGML_CUDA=ON включает видеокарту. RTX 5090 и RTX PRO 6000 Blackwell — одна архитектура, поэтому в сборке для обоих способов нужен -DCMAKE_CUDA_ARCHITECTURES=120. Без этого флага готовый сервер не считает на этих картах. Цель сборки — только llama-server. Эту сборку делают один раз для обоих способов.
nvidia-smi
apt-get update
apt-get install -y git cmake build-essential wget ca-certificates \
  cuda-nvcc-12-8 cuda-cudart-dev-12-8 cuda-cccl-12-8 libcublas-dev-12-8 libcurand-dev-12-8
export PATH=/usr/local/cuda-12.8/bin:$PATH
mkdir -p /workspace
cd /workspace
git clone --depth 1 https://github.com/ggml-org/llama.cpp
cd llama.cpp
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=120
cmake --build build --config Release -j"$(nproc)" --target llama-server
Готовый файл — /workspace/llama.cpp/build/bin/llama-server. Сборка на арендованной карте занимает несколько минут.
Установка Q6_K
Этот способ для одной карты на 32 ГБ. Репозиторий — DavidAU/Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF. Берите обычный квант Q6_K, без букв MTP в имени. Контекст — 16 384 токена. Ключ -c у wget докачивает файл с места обрыва. После загрузки размер должен быть ровно 23582382688. Короткий файл значит, что скачивание оборвалось: повторите тот же wget. Если число байт перестало расти, ту же команду запускают снова: ключ -c продолжает файл.
mkdir -p /workspace/models
wget -c -O /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q6_K.gguf \
  https://huggingface.co/DavidAU/Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF/resolve/main/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q6_K.gguf
stat -c %s /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q6_K.gguf
На этом образе code-server уже слушает 127.0.0.1:8080, поэтому флаг --host 0.0.0.0 не занимает порт: в логе будет couldn’t bind HTTP server socket. Чат поднимают на адресе интерфейса eth0 и на том же порту 8080. Публичная ссылка из My Orders со страницей CLORE.AI ML Tools ведёт на nginx порта 80, а не на llama-server. code-server оставляют запущенным: через него открывается веб-редактор. Поле сообщения — кнопка Llama Chat, раздел ниже.
cd /workspace/llama.cpp
HOST=$(ip -4 -o addr show eth0 | awk '{print $4}' | cut -d/ -f1)
nohup ./build/bin/llama-server \
  -m /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q6_K.gguf \
  --host "$HOST" \
  --port 8080 \
  -c 16384 \
  -ngl 99 \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 20 \
  --repeat-penalty 1.0 \
  > /workspace/llama.log 2>&1 &
tail -f /workspace/llama.log
Дождитесь в логе строк model loaded и listening с портом 8080, затем откройте ссылку этого порта в My Orders. Загрузка весов в память занимает минуту. Сессию SSH после этой строки можно закрыть: процесс запущен через nohup и пишет лог в /workspace/llama.log.
Установка Q8_0
Этот способ для одной RTX PRO 6000 Blackwell на 96 ГБ. Файл — обычный Q8_0, без букв MTP в имени. Контекст — 262 144 токена. Если на этой машине уже слушает чат Q6_K, остановите его: иначе порт 8080 занят.
pkill -f llama-serverПосле загрузки размер должен быть ровно 29787699808.
mkdir -p /workspace/models
wget -c -O /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q8_0.gguf \
  https://huggingface.co/DavidAU/Qwen3.8-27B-TURBO-Fable-Cold-Fusion-735-882-Heretic-Uncensored-NEO-CODER-MAX-MTP-GGUF/resolve/main/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q8_0.gguf
stat -c %s /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q8_0.gguf
cd /workspace/llama.cpp
HOST=$(ip -4 -o addr show eth0 | awk '{print $4}' | cut -d/ -f1)
nohup ./build/bin/llama-server \
  -m /workspace/models/Qwen3.8-27B-TurboFCFusion-735-882-Here-Uncen-NEO-CODER-MAX-Q8_0.gguf \
  --host "$HOST" \
  --port 8080 \
  -c 262144 \
  -ngl 99 \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 20 \
  --repeat-penalty 1.0 \
  > /workspace/llama.log 2>&1 &
tail -f /workspace/llama.log
Строки model loaded и listening с портом 8080 значат, что чат Q8_0 поднялся. Ссылка та же, из My Orders. На проверенной RTX PRO 6000 контекст 262 144 поместился: после загрузки занято около 44 ГБ из 96 ГБ. Предупреждение в логе, что порт по умолчанию в будущем выпуске сменят на 9931, не меняет порт заказа: флаг --port 8080 по-прежнему открывает чат на порту заказа. Веса Q8_0 грузятся дольше, чем Q6_K: файл больше.
Где писать сообщение
Ссылка веб-интерфейса в My Orders открывает страницу CLORE.AI ML Tools. Jupyter Lab и Visual Studio Code Web — редакторы кода. Поля для сообщения там нет.
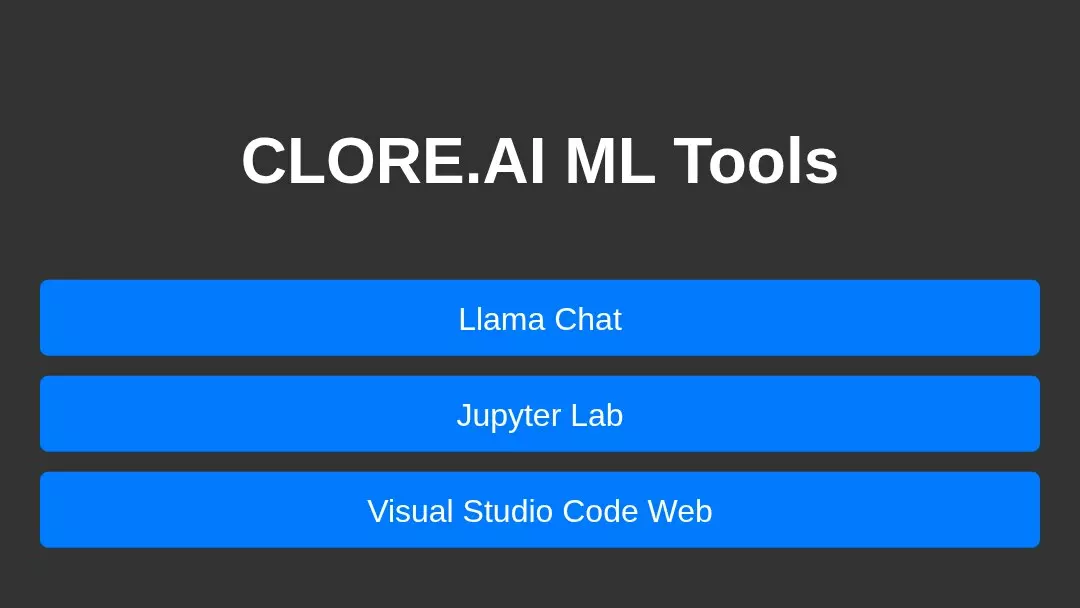
Чат — кнопка Llama Chat. На образе её нет, пока её не добавите: nginx на порту 80 отдаёт меню, а llama-server слушает адрес eth0 и порт 8080. Фрагмент ниже проксирует путь /chat/ на этот адрес и ставит кнопку первой.
HOST=$(ip -4 -o addr show eth0 | awk '{print $4}' | cut -d/ -f1)
export HOST
python3 - << 'PY'
import os
from pathlib import Path
ip = os.environ["HOST"]
nginx = Path("/etc/nginx/sites-enabled/default")
text = nginx.read_text()
block = """
    location /chat/ {
        proxy_pass http://%s:8080/;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";
        proxy_buffering off;
        proxy_read_timeout 3600s;
    }

""" % ip
if "location /chat/" not in text:
    text = text.replace("    location /code-server/ {", block + "    location /code-server/ {", 1)
    nginx.write_text(text)
index = Path("/var/www/html/index.html")
html = index.read_text()
needle = '<a class="link" href="/jupyter">Jupyter Lab</a>'
if "Llama Chat" not in html:
    html = html.replace(needle, '<a class="link" href="/chat/">Llama Chat</a>\n        ' + needle, 1)
    index.write_text(html)
PY
nginx -t && nginx -s reload
После проверки nginx обновите страницу меню и нажмите Llama Chat.
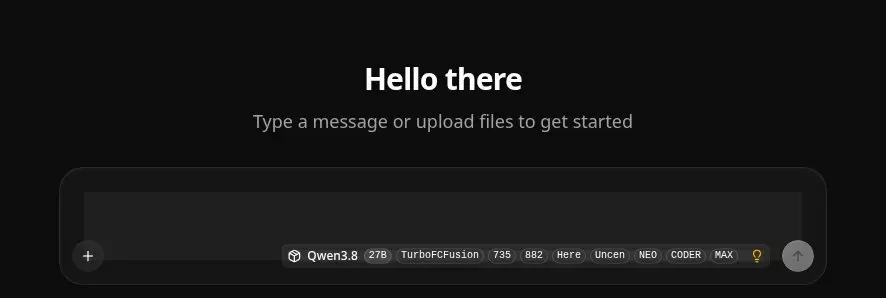
В чате строка Type a message or upload files to get started стоит над полем. Текст пишут в тёмную рамку под ней. Серая стрелка справа отправляет сообщение. Подписи Qwen3.8 и 27B показывают, что открыт нужный файл.
Проверочный запрос
Проверка одна и та же для обоих способов. В тёмном поле под строкой Type a message or upload files to get started отправьте:
Напиши короткий рассказ о красном велосипеде на мокрой брусчатке утром. Восемь предложений, без ругани.Сначала модель пишет блок рассуждения, затем сам рассказ. Пока идёт рассуждение, страница может несколько секунд не показывать итоговый текст. Это штатный режим шаблона Qwen3.8, а не зависание. Готовый ответ — связный рассказ про велосипед, без отказа и без перехода на другую тему. На таком коротком запросе Q6_K и Q8_0 дают похожий текст. Разница Q8_0 проявляется на длинном диалоге и на точных деталях, как в разделе выше.
Частые вопросы
Сколько памяти нужно Q6_K?
Файл занимает 23 582 382 688 байт. Вместе с контекстом 16 384 токена он рассчитан на видеокарту 32 ГБ. На проверенной RTX 5090 занято около 24 ГБ из 32 ГБ.
Какая карта нужна для Q8_0?
Файл Q8_0 занимает 29 787 699 808 байт. Вместе с контекстом 262 144 токена его держит одна RTX PRO 6000 Blackwell на 96 ГБ.
В чём пользователь замечает разницу?
На коротком письме или рассказе ответы похожи. На Q8_0 длинный диалог и большая вставка не вытесняют начало: контекст 262 144 токена против 16 384 у Q6_K. Точные имена, числа и плотный код у Q8_0 держатся чуть ровнее. Более быстрая карта с теми же 32 ГБ ускоряет Q6_K, текст при том же файле тот же.
Почему страница порта 8080 не открывается?
На проверенном образе code-server уже занял 127.0.0.1:8080, поэтому --host 0.0.0.0 не стартует. Чат слушает адрес eth0 и порт 8080. В логе нужны строки model loaded и listening. Порт в заказе — 8080/http. Образы Ollama и ComfyUI этот чат не поднимают.
Почему ответ начинается с длинного рассуждения?
Шаблон Qwen3.8 по умолчанию включает режим рассуждения. Итоговый текст идёт после этого блока.
Для чего обычным пользователям эта модель?
Для своего чата на арендованной карте: черновик, разбор команды, короткий текст. Запрос не уходит в публичный сервис. Фильтр отказа публичной Qwen3.8-27B в этой сборке снят, закон при этом не меняется.
Без почты и трекеров — только лента обновлений.